El mito del 'mejor modelo': por qué la IA falla por los datos, no por el LLM
Un modelo de lenguaje más grande no resuelve una arquitectura de datos deficiente. La mayoría de los proyectos de IA que fracasan en producción no fallan por el modelo: fallan por una capa de datos no gobernada.
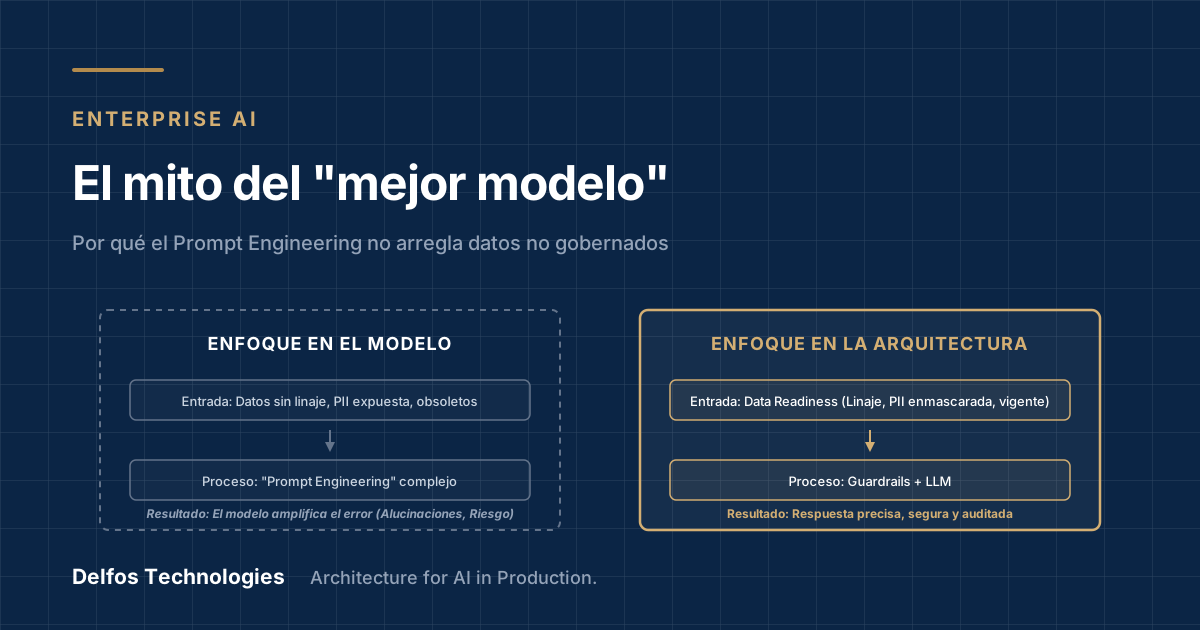
Un modelo de lenguaje más grande no resuelve una arquitectura de datos deficiente.
La mayoría de los proyectos de IA que fracasan en producción no fallan por las limitaciones del modelo. Fallan por una capa de datos no gobernada.
Alimentar un sistema de IA con documentos desactualizados, no autorizados o con información personal expuesta no es “preparar el conocimiento”. Es escalar el riesgo operativo, legal y reputacional.
La preparación real para IA empresarial (Data Readiness) exige tres controles fundamentales:
-
Linaje: Saber con certeza la procedencia y el contexto de cada dato que alimenta al modelo.
-
Control de acceso (Zero Trust): Garantizar que la IA respete estrictamente los permisos granulares de cada usuario en cada consulta.
-
Vigencia: Contar con mecanismos que invaliden el conocimiento obsoleto antes de que alcance el modelo.
La IA no limpia datos sucios. Los amplifica.
La pregunta crítica para la mesa directiva no es qué modelo elegir, sino si la arquitectura de datos está lista para sostenerlo.
¿Su organización está priorizando la preparación de sus datos, o solo la sofisticación del prompt?
Me interesaría conocer su enfoque en los comentarios.
Este insight se publicó originalmente en LinkedIn.
Ver la conversación en LinkedIn →
Escrito por
Ing. Enrique Landaure Vásquez
Founder & Principal AI Systems Architect @ Delfos Technologies
Especialista en Arquitectura Empresarial para IA sobre AWS. Con más de dos décadas diseñando infraestructura crítica, cloud, networking y arquitecturas empresariales para entornos de alta exigencia en Latinoamérica. MBA y Diploma en Transformación Digital por EUDE Business School (España).